高效数据操作的五大特点
由于其广泛的功能和多样性,pandas已经在每个数据科学家的心中占有一席之地。
从数据输入/输出到数据清洗和转换,想象一下没有import pandas as pd进行数据操作是几乎不可能的,对吧?
现在,请跟我一起:在过去的几个月里,由于LLMs的热度,我不知道pandas刚刚经历了一次重大发布!是的,pandas 2.0已经发布,并且带着强大的功能!
尽管我不知道所有的热度,但数据中心的AI社区及时出手援助:
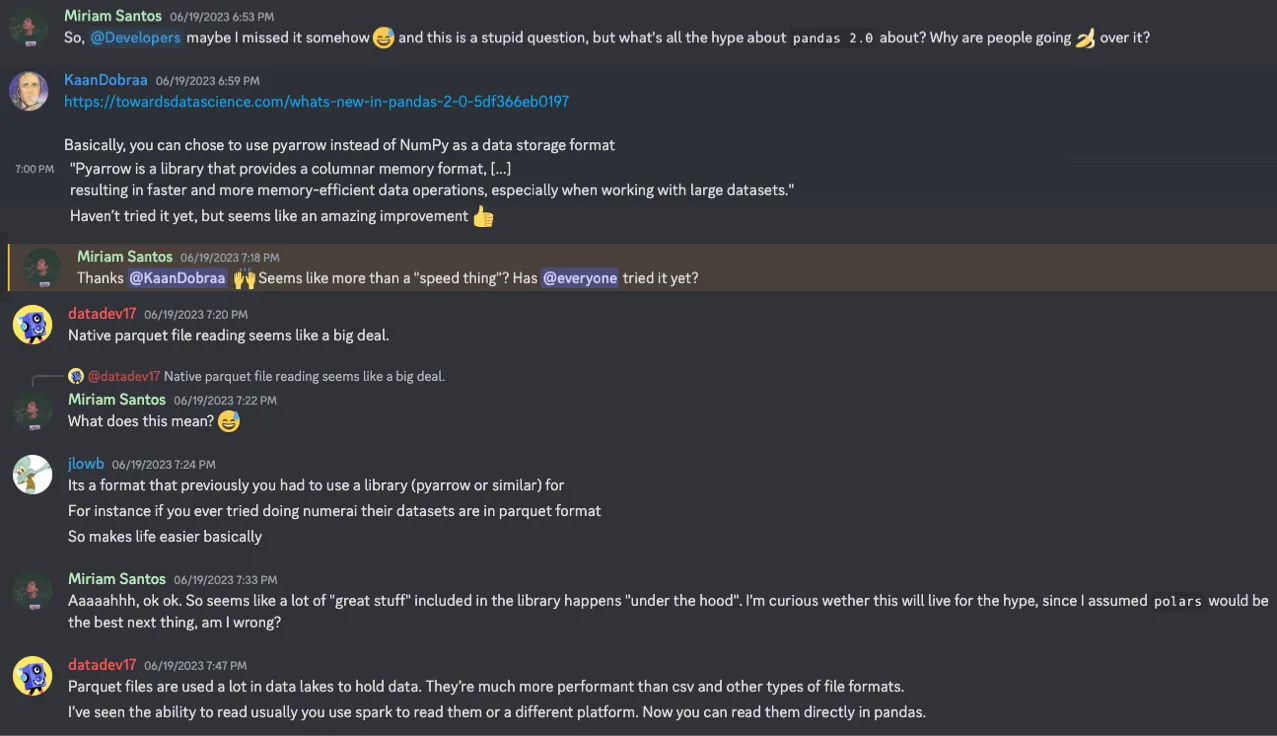
有趣的事实:你知道这个版本已经开发了惊人的三年时间了吗?这就是我所说的“对社区的承诺”!
pandas 2.0有什么新特性?让我们来看看!
1. 性能、速度和内存效率
我们都知道,pandas是使用numpy构建的,而numpy并不是用于数据框库的后端。因此,pandas的主要局限性之一就是处理较大数据集的内存处理。
在这个版本中,最大的变化来自于Apache Arrow为 pandas 数据引入的后端。
Arrow本质上是一种标准化的内存列数据格式,可用于多种编程语言的库(C、C++、R、Python等)。对于Python,有基于Arrow C++实现的PyArrow,因此非常快!
因此,长话短说,PyArrow解决了我们在1.X版本中的内存限制,使我们能够进行更快速、更节省内存的数据操作,特别是对于大型数据集。
这里是使用Hacker News数据集(约650 MB,许可证CC BY-NC-SA 4.0)读取数据的比较:
使用pyarrow的read_csv()与不使用的比较,前者快了35倍。作者截图。
正如您所看到的,使用新的后端使读取数据的速度快了近35倍。其他值得指出的方面包括:
- 没有使用
pyarrow后端,每个列/特征都存储为其自己独特的数据类型:数字特征存储为int64或float64,而字符串值存储为对象; - 使用
pyarrow,所有特征都使用Arrow dtypes:注意[pyarrow]注释和不同类型的数据:int64,float64,string,timestamp和double:
df.info(): 探究每个DataFrame的数据类型。作者提供的片段。
2. Arrow数据类型和Numpy索引
除了读取数据,也就是最简单的情况,你可以期待一系列其他操作的额外改进,尤其是涉及字符串操作的操作,因为pyarrow的字符串数据类型实现非常有效:
比较字符串操作: 展示arrow实现的效率。作者提供的片段。
事实上,Arrow具有更多(和更好的支持)的数据类型,这些数据类型在科学(数值)范围之外是必需的: 日期和时间、持续时间、二进制、十进制、列表和映射。浏览pyarrow支持和numpy数据类型之间的等价性实际上可能是一个很好的练习,如果你想学习如何利用它们。
现在也可以在索引中容纳更多的numpy数字类型。传统的int64、uint64和float64为所有numpy数字数据类型的索引值打开了空间,因此我们可以指定它们的32位版本:
利用32位numpy索引,使代码更加内存高效。作者提供的片段。
这是一个受欢迎的变化,因为索引是pandas中使用最多的功能之一,允许用户过滤、连接和洗牌数据,以及其他数据操作。实际上,索引越轻,这些过程就越有效率!
3. 更容易处理缺失值
由于建立在numpy之上,使得pandas难以以一种轻松、灵活的方式处理缺失值,因为numpy不支持某些数据类型的空值。
例如,整数会自动转换为浮点数,这是不理想的:
缺失值: 转换为浮点数。作者提供的片段。
请注意,在引入单个None值后,points自动从int64更改为float64。
对于数据流来说,没有比错误的类型集更糟糕的了,尤其是在数据中心的AI范式内。
错误的类型集直接影响数据准备决策,在不同数据块之间引起不兼容性,甚至在默默地通过时,它们可能会损害某些操作,导致返回无意义的结果。
例如,在数据中心的AI社区中,我们目前正在开展一项关于数据隐私的合成数据项目。其中之一的特点是NOC(子女数量),在加载数据时具有缺失值,因此会自动转换为float。然后,将数据作为float传递给生成模型时,我们可能会得到小数值的输出,例如2.5——除非你是有2个孩子、一个新生儿和一种奇怪幽默感的数学家,否则拥有2.5个孩子是不可行的。
在pandas 2.0中,我们可以利用dtype = 'numpy_nullable'处理缺失值,而不改变原始数据类型,因此我们可以保持我们的原始数据类型(在这种情况下为int64):
利用‘numpy_nullable’,pandas 2.0可以处理缺失值,而不改变原始数据类型。作者提供的片段。
它可能看起来像一个微小的变化,但在幕后,它意味着现在pandas可以原生地使用Arrow处理缺失值的实现。这使得操作变得更加高效,因为pandas不必为每种数据类型实现自己的处理空值版本。
4. 写时复制优化
Pandas 2.0 还添加了一种新的惰性复制机制,它推迟了对 DataFrame 和 Series 对象的复制直到它们被修改。
这意味着某些方法在启用写时复制时将返回视图而不是副本,从而通过最小化不必要的数据复制来提高内存效率。
这也意味着在使用链式赋值时需要特别小心。
如果启用了写时复制模式,链式赋值将不起作用,因为它们指向一个临时对象,该对象是索引操作的结果(在写时复制下行为类似于副本)。
当禁用写时复制时,像切片这样的操作可能会改变原来的 df,如果新的数据框被更改:
禁用写时复制:原始数据框在链式赋值中被更改。作者提供的片段。
当 copy_on_write 启用时,赋值时会创建一个副本,因此原始数据框永远不会更改。Pandas 2.0 将在这些情况下引发 ChainedAssignmentError 以避免静默错误:
启用写时复制:原始数据框在链式赋值中没有被更改。作者提供的片段。
5. 可选依赖项
使用 pip 时,版本 2.0 为我们提供了安装可选依赖项的灵活性,这在定制和优化资源方面是一个加号。
我们可以根据特定需求定制安装,而不会浪费磁盘空间。
此外,它可以节省很多“依赖关系的头疼”,减少与我们可能在开发环境中拥有的其他软件包的兼容性问题或冲突的可能性:
安装可选依赖项。作者提供的片段。
试一试!
然而,问题仍然存在:这个热点真的如此值得吗?我很好奇 Pandas 2.0 是否在我日常使用的某些软件包方面提供了重大改进:ydata-profiling、matplotlib、seaborn、scikit-learn。
从中,我决定试试 ydata-profiling——它刚刚添加了对 Pandas 2.0 的支持,这似乎是社区必备的!在新版本中,用户可以确保如果使用了 Pandas 2.0,他们的管道不会中断,这是一个重大的优点!但是还有什么?
老实说,ydata-profiling 是我最喜欢的探索性数据分析工具之一,也是一个不错的快速基准测试——对我来说只有一行代码,但在幕后它充满了我作为数据科学家需要解决的计算——描述性统计、直方图绘制、分析相关性等等。
那么有什么比用最少的努力一次性测试 pyarrow 引擎对所有这些的影响更好的方法吗?
使用 ydata-profiling 进行基准测试。作者提供的片段。
同样,使用 pyarrow 引擎读取数据肯定更好,尽管在创建数据文件时,速度并没有发生显着变化。
然而,差异可能取决于内存效率,我们需要进行不同的分析。此外,我们可以进一步研究在数据上进行的分析类型:对于某些操作,1.5.2 和 2.0 版本之间的差异似乎是微不足道的。
但我注意到可能会对这方面产生影响的主要事情是 ydata-profiling 尚未利用 pyarrow 数据类型。这个更新可能在速度和内存方面产生巨大的影响,这是我期待未来发展的地方!
裁决:性能、灵活性、互操作性!
这个新的pandas 2.0版本带来了很多灵活性和性能优化,其中包含了许多“在幕后”进行的微妙但至关重要的修改。
对于那些不熟悉数据操作领域的新手来说,这些修改可能并不很“显眼”,但对于那些曾经不得不费尽周折克服旧版本限制的老练数据科学家来说,它们就像是沙漠中的水源。
总之,这些是新版本引入的主要优点:
- 性能优化:通过引入Apache Arrow后端、更多的numpy dtype索引和写时复制模式来实现;
- 增加了灵活性和定制性:允许用户控制可选依赖项并利用Apache Arrow数据类型(包括从一开始就具有的可空性!);
- 互操作性:也许这是新版本中不太“声名显赫”的优点,但它具有巨大的影响。由于Arrow是语言无关的,因此可以在使用Apache Arrow后端的不仅是Python,而且还有R、Spark和其他程序之间传输内存数据!
以上就是全部内容!我希望这篇文章能够回答你关于pandas 2.0及其在数据操作任务中的适用性方面的一些问题。
我仍然很好奇你在日常编码中是否发现了pandas 2.0的重大差异!如果你愿意,可以在Data-Centric AI社区找到我,让我知道你的想法!我们在那里见吧?
关于我
博士,机器学习研究员,教育者,数据倡导者,总的来说是一个“万能的人”。在小猪AI上,我撰写关于数据中心的AI和数据质量的文章,教育数据科学和机器学习社区如何从不完美的数据中移动到智能数据。
YData开发者关系 | Data-Centric AI社区 | GitHub | Instagram | Google Scholar | LinkedIn