探索NODE:一种用于表格数据的神经决策树架构
近年来,机器学习变得非常流行,神经深度学习模型在图像和文本处理等复杂任务上已经远远超越了XGBoost [4]等浅层模型。然而,对于表格数据而言,深度模型通常不如这些浅层模型有效,并且没有一种通用的深度学习方法能够始终胜过梯度提升树。
为了弥补这一差距,俄罗斯互联网服务公司Yandex的研究人员提出了一种新的架构:神经遗忘决策集成(NODE)[1]。该网络利用轻量级和可解释的神经决策树,并将其整合到神经网络框架中。这使得模型能够捕捉表格数据中的复杂交互和依赖关系,同时保持可解释性。
在本文中,我将解释NODE的工作原理以及使其成为一个强大且可解释的预测模型的各种特性。像往常一样,我鼓励大家阅读原始论文。如果您想使用NODE,请查看该模型的GitHub。
本文是关于神经决策树的系列文章的一部分,这些架构具有与传统深度网络相当的预测能力,并且高度可解释。

Nakul Upadhya
软/神经决策树
查看列表2个故事

NODE决策树结构
神经决策树
本文假设您对神经决策树有一定的了解。如果您不了解,我强烈建议阅读我关于神经决策树的先前文章,以获得详细的解释。然而,简而言之:神经决策树既是软决策树又是斜决策树。
斜决策树是一种在每个节点中使用多个变量进行决策的树(通常以线性组合的形式排列)。例如,为了预测车祸,正交树可能使用“car_speed – speed_limit < 10”这样的规则来产生一个分支决策。这与“正交”树(如CART,即基本决策树)不同,后者在任何给定节点只使用一个变量,并且需要更多的节点来近似相同的决策边界。
软树是指所有的分支决策都是概率性的,并且每个节点的计算定义了进入特定分支的概率。这与常规的“硬”决策树(如CART)不同,后者的每个分支决策都是确定性的。
由于该树不限制每个节点中使用的变量数量,并且分支决策是连续的,整个树是可微分的。由于整个树是可微分的,它可以集成到任何神经网络框架(如Pytorch或Tensorflow)中,并使用传统的神经优化器(如随机梯度下降和Adam)进行训练。
NODE树
NODE使用的决策树与传统的神经树略有不同。让我们来分析所有的区别。
遗忘性质
首要的变化是树的遗忘性质。这意味着树在同一深度的所有内部节点上使用相同的分裂权重和阈值。因此,遗忘决策树(ODTs)可以表示为具有2^ d条目的决策表(其中d是深度)。一个好处是,与传统决策树相比,ODTs更具可解释性,因为需要解析的决策更少,决策路径更容易可视化和理解。然而,由于分裂函数的约束性质,ODTs在与传统决策树相比是更弱的学习器。
所以,如果我们的目标是性能,为什么要使用ODTs?正如CATBoost [2]的开发人员所展示的那样,ODTs在集成在一起时表现得非常好,并且对数据过拟合的倾向较小。此外,ODTs的推理非常高效,因为可以并行计算所有的分割以快速找到表中的适当条目。
用于特征选择和分支的Entmax
NODE相对于传统神经决策树的第二个改进是在其架构中使用了alpha-entmax [3] 而不是sigmoid。Alpha-entmax是softmax的广义版本,能够产生大部分结果等于零的稀疏分布。这种稀疏性由一个参数(alpha,因此得名)控制,alpha越高,分布越稀疏。

这种转换在两个关键位置上使用。第一个用途是稀疏特征选择。NODE包括一个可训练的特征选择权重矩阵F(大小为d x n,其中n是特征数量,d是树的深度),通过entmax转换传递。由于entmax转换的大多数条目都等于零,这自然而然地导致每个决策节点中使用的特征数量较少。

除了特征选择外,entmax还用于分支概率。这是通过传递分支函数的结果,减去一个学习得到的阈值,并适当缩放它来实现的。然后将该值与0连接起来,并传递到entmax函数中创建一个2类概率分布,这正是我们分支所需要的。

使用这个,我们可以通过计算所有分支分布c的外积来定义一个“选择”张量C。然后可以将其乘以叶子中的值来创建网络的结果。
集成
正如其名称所示,这些神经不可知决策树被集成在一起。NODE层被定义为m个单独树的串联,每个树都有自己的分支决策和叶子值。正如之前提到的,这种集成与单个树的不可知性相辅相成,有助于提高准确性并降低过拟合的机会。
多层NODE
NODE是一个灵活的架构,可以单独训练(结果是一组决策树的单个集成)或与复杂的多层结构一起训练,其中每组集成从前一层获取输入。

NODE的多层架构紧随流行的DenseNet架构。每个NODE层包含多个树,它们的输出被串联起来,并成为后续层的输入。最终的输出是通过对所有层的所有树的输出进行平均得到的。由于每一层都依赖于所有先前预测的链条,网络可以捕捉到复杂的依赖关系。
实验性能
为了测试他们的架构,Popov等人(2019)将NODE与CatBoost [2],XGBoost [4],完全连接的神经网络,mGBDT [5]和DeepForest [6]进行了比较。他们的方法是在六个不同的数据集上测试模型。具体而言,他们进行了一个使用每个模型的默认参数进行比较,以及另一个使用每个模型进行了调整超参数的比较。
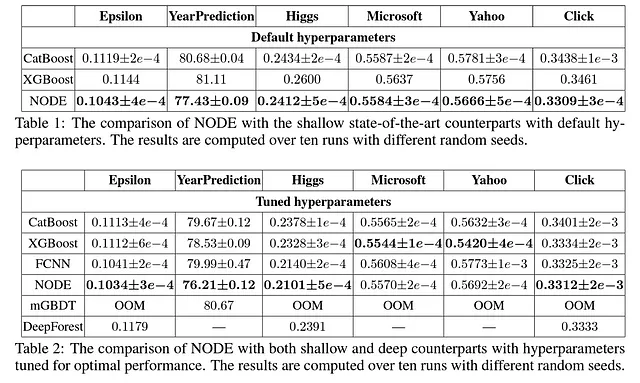
NODE的实验结果非常令人鼓舞。首先,NODE架构在默认参数下优于所有其他模型。即使使用调整的参数,NODE在6个选择的数据集中仍然优于大多数其他模型的表现。
结论
通过将决策树的优势融入神经网络架构,NODE为结构化表格数据普遍存在的领域,如金融、医疗保健和客户分析,提供了新的深度学习应用的可能性。
然而,这并不意味着NODE是完美的。首先,架构的集成意味着使用神经决策树时许多局部可解释性的提升被丢弃,只能从模型中获取全局特征重要性。然而,这种架构为提高神经可解释性提供了构建模块,并且已经提出了后续模型(NODE-GAM [7])来弥合可解释性差距。
此外,尽管NODE优于许多浅层模型,但我使用它的经验表明,即使使用GPU进行训练,它也需要更长的时间(这一结论得到了论文作者提供的实验结果的支持)。
总体而言,这是一种非常有前途的方法,我计划将其作为我未来开发的深度学习模型的组成部分积极使用。
资源和参考文献
- NODE论文:https://arxiv.org/abs/1909.06312
- NODE代码:https://github.com/Qwicen/node
- NODE还可以在Pytorch Tabular包中找到:https://github.com/manujosephv/pytorch_tabular
- 如果您对可解释机器学习或时间序列预测感兴趣,请考虑关注我:https://medium.com/@upadhyan
- 查看我关于神经决策树的其他文章:https://medium.com/@upadhyan/list/3b4a9cb97b84
参考文献
[1] Popov, S., Morozov, S., & Babenko, A. (2019). Neural oblivious decision ensembles for deep learning on tabular data. Eight International Conference on Learning Representations.
[2] Prokhorenkova, L., Gusev, G., Vorobev, A., Dorogush, A. V., & Gulin, A. (2018). CatBoost: unbiased boosting with categorical features. Advances in neural information processing systems , 31 .
[3] Peters, B., Niculae, V., & Martins, A. (2019). Sparse Sequence-to-Sequence Models. In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (pp. 1504–1519). Association for Computational Linguistics.
[4] Chen, T., & Guestrin, C. (2016, August). Xgboost: A scalable tree boosting system. In Proceedings of the 22nd acm sigkdd international conference on knowledge discovery and data mining (pp. 785–794).
[5] Feng, J., Yu, Y., & Zhou, Z. H. (2018). Multi-layered gradient boosting decision trees. Advances in neural information processing systems , 31 .
[6] Zhou, Z. H., & Feng, J. (2019). Deep forest. National science review , 6 (1), 74–86.
[7] Chang, C.H., Caruana, R., & Goldenberg, A. (2022). NODE-GAM:神经广义可加模型用于可解释深度学习。在国际学习表征会议上。