MLOps团队承受着推进AI规模化能力的压力我们与福特汽车合作,探讨如何在组织内规模化MLOps以及如何开始
由Mike Caravetta和Brendan Kelly撰写
为您的团队扩展MLOps
MLOps团队正面临推进AI规模的压力。在2022年,我们看到了组织内外围绕AI和MLOps的热潮。2023年,ChatGPT的成功和企业内模型的推广将带来更多的炒作。
MLOps团队希望扩展其能力,同时满足业务的迫切需求。这些团队以改进工业化AI的方式为起点,制定了一长串的决心和计划。我们如何扩展MLOps的组件(部署、监控和治理)?我们团队的首要任务是什么?
AlignAI与福特汽车公司合作编写了这本指南,以指导MLOps团队,基于我们所看到的成功经验进行扩展。
MLOps是什么意思?
首先,我们需要一个MLOps的工作定义。MLOps是组织从提供少数AI模型到可靠地提供算法的转变。这种转变需要一个可重复和可预测的过程。MLOps意味着更多的AI和相关的投资回报。当团队关注流程、团队和工具的编排时,他们就能在MLOps上获胜。
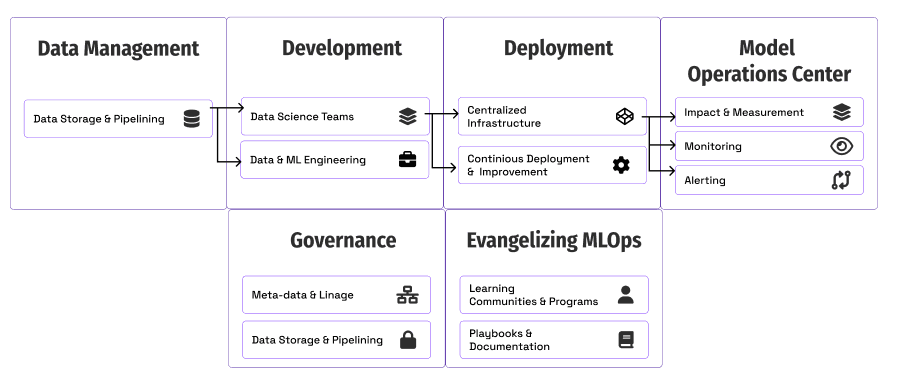
扩展MLOps的基础组件
让我们通过福特汽车的实例和一些想法来逐个讲解每个领域。
- 测量和影响:团队如何跟踪和衡量进展。
- 部署和基础架构:团队如何扩展模型部署。
- 监控:维护生产中模型的质量和性能。
- 治理:在模型周围创建控制和可见性。
- 倡导MLOps:教育业务和其他技术团队如何利用MLOps方法。
测量和影响
有一天,一位业务主管走进福特汽车的MLOps指挥中心。我们审查了一个模型的使用情况指标,就此展开了一次富有成效的对话,讨论了使用量下降的原因。这种模型使用情况和采用情况的可见性对于建立信任和应对业务需求至关重要。
对于利用AI并投资于MLOps能力的团队,一个基本问题是我们如何知道我们是否在进步?
关键在于我们如何将团队对我们的客户和业务利益相关者提供的价值进行对齐。团队关注于量化业务影响和实现业务影响的操作指标。测量影响捕捉了我们如何创造价值的全貌。
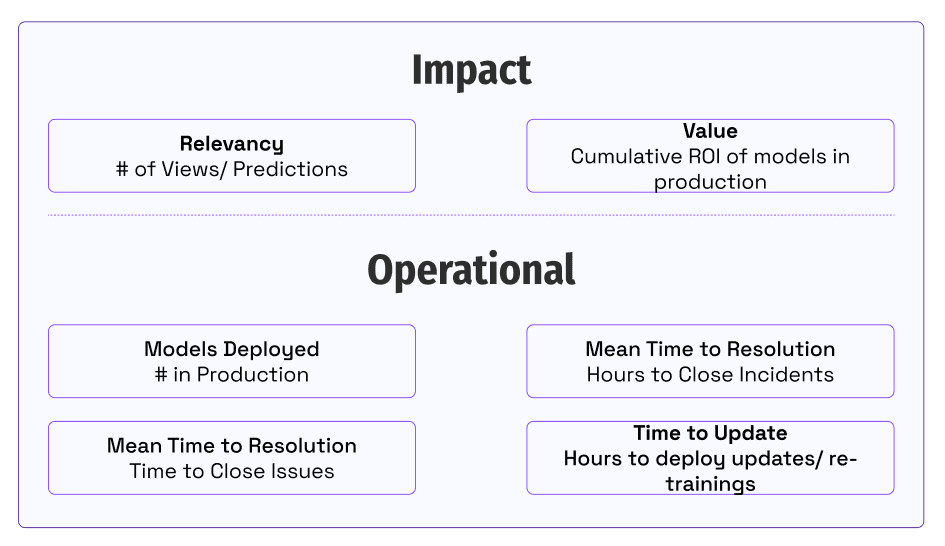
开始的想法:
- 您如何衡量当前正在开发或生产中的模型的价值?您如何跟踪您的业务利益相关者的使用和参与度?
- 您的生产模型的操作或工程指标是什么?谁负责改善这些指标?您如何让人们查看这些指标?
- 人们如何知道用户行为或解决方案使用是否发生了变化?谁负责回应这些问题?
部署和基础架构
团队在MLOps中面临的第一个难关是将模型部署到生产环境中。随着模型数量的增长,团队必须创建一个标准化的过程和共享平台来处理增加的模型数量。管理使用20种不同模式部署的20个模型可能会变得繁琐。企业团队通常在X个模型周围创建集中的基础架构资源。在模型和团队之间选择正确的架构和基础架构可能是一项艰巨的任务。但是,一旦它被建立起来,它就为围绕监控和治理构建能力提供了坚实的基础。
在福特汽车公司,我们使用Kubernetes、Google Cloud Platform和一个团队来创建标准的部署功能。
Lucid Link
您的团队的想法:
- 您将如何集中化模型的部署?您能否创建或指定一个集中化的团队和资源来管理部署?
- 什么是您的模型在生产中的部署模式(REST、批处理、流处理等)?
- 您将如何定义并与其他团队共享这些模式?
- 对于您的建模团队而言,哪些是最耗时或困难的方面,以将模型投入生产?集中化部署系统如何设计以减轻这些问题?
监控
机器学习中独特而具有挑战性的一点是,模型在生产中会发生漂移和变化。监控在与利益相关者建立信任以使用模型方面至关重要。Google的机器学习规则指出:“实践良好的警报卫生习惯,例如制定具有可执行性的警报。”这要求团队定义需要监测的区域以及如何生成这些警报。一个具有挑战性的部分是使这些警报具有可操作性。需要建立一个流程来调查和缓解生产中的问题。
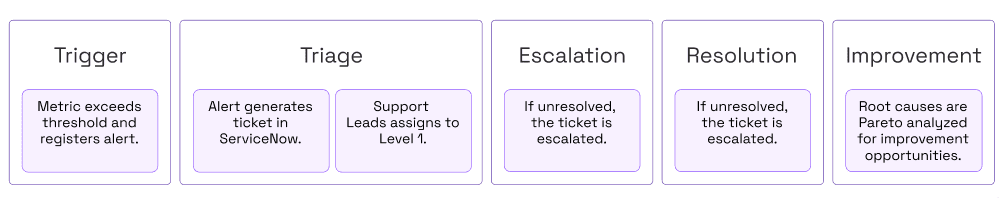
在福特公司,模型操作中心是一个集中的位置,屏幕上充满了信息和数据,以了解模型是否在近实时中得到我们期望的结果。
以下是一个简化的仪表板示例,查找使用情况或记录计数是否低于设定的阈值。
监控指标
以下是考虑您的模型的监控指标:
- 延迟:返回预测所需的时间(例如,100条记录的批处理处理时间)。
- 统计性能:模型根据测试数据集进行正确或接近预测的能力(例如,均方误差,F2等)。
- 数据质量:预测或训练数据的完整性,准确性,有效性和及时性的量化(例如,缺少功能的预测记录的百分比)。
- 数据漂移:随时间改变数据分布(例如,计算机视觉模型的光照变化)。
- 模型使用:模型预测用于解决业务或用户问题的频率(例如,作为REST端点部署的模型的预测次数)。
团队的想法:
- 所有模型应如何监控?
- 每个模型需要包含哪些指标?
- 是否有标准的工具或框架来生成指标?
- 我们将如何处理监控警报和问题?
治理
创新本质上会带来风险,尤其是在企业环境中。因此,成功地领导创新需要将控制措施设计到系统中以减轻风险。积极主动可以节省很多麻烦和时间。MLOps团队应积极预见并教育利益相关者风险以及如何减轻风险。
开发治理的积极方法有助于避免对业务需求做出反应。策略的两个关键要素是控制对敏感数据的访问以及捕获可见性和审计的谱系和元数据。
治理为团队扩展提供了自动化的巨大机会。等待数据是数据科学项目的不断动力杀手。在福特公司,一个模型自动确定数据集中是否存在个人身份信息,并具有97%的准确性。机器学习模型还有助于访问请求,并在90%的情况下将处理时间从几周缩短到几分钟。
另一个部分是跟踪模型的生命周期中的元数据。扩展机器学习要求在生产中内置质量,安全性和控制,以避免问题和偏差。
团队可能会陷入治理理论和观点中。最好的做法是从用户访问的明确访问和控制开始。
从那里开始,元数据捕获和自动化是关键。下表概述了收集元数据的区域。在可能的情况下,利用管道或其他自动化系统自动捕获此信息,以避免手动处理和不一致性。
收集的元数据
以下是每个模型需要收集的项目:
- 版本/训练模型工件:训练模型工件的唯一标识符。
- 训练数据-用于创建训练模型工件的数据
- 培训代码-Git哈希或推理源代码的链接。
- 依赖项-训练中使用的库。
- 预测代码-Git哈希或推理源代码的链接。
- 历史预测-存储推理以进行审计目的。
团队的想法:
- 我们在项目中遇到了哪些问题?
- 我们的业务利益相关者遇到或担心哪些问题?
- 我们如何处理数据的访问请求?
- 谁批准它们?
- 是否有自动化机会?
- 我们的模型管道或部署存在哪些漏洞?
- 我们需要捕获哪些元数据?
- 它是如何存储和提供的?
宣传MLOps
许多技术团队都陷入了这样的误区:“如果我们建造它,他们就会来。” 解决问题还需要分享和推广解决方案,以增加组织影响力。 MLOps团队需要分享最佳实践以及如何解决组织工具、数据、模型和利益相关者的独特问题。
通过与业务利益相关者合作展示他们的成功案例,MLOps团队中的任何人都可以成为传道者。 展示组织中的示例可以清晰地说明好处和机会。
在整个组织寻求实现AI的工业化的人需要教育、文档和其他支持。 午餐和学习、入职培训和导师计划是一个很好的开始。 随着您的组织扩大规模,更加正式的学习和入职计划以及相关文档支持可以加速您的组织转型。
您的团队的想法:
- 如何为MLOps创建社区或定期的学习和最佳实践?
- 我们需要建立和分享哪些新角色和能力?
- 我们解决的问题可以分享吗?
- 您如何提供培训或文档,以与其他团队分享最佳实践和成功案例?
- 我们如何为数据科学家、数据工程师和业务利益相关者创建学习计划或清单,以了解如何使用AI模型进行工作?
入门指南
MLOps团队和领导者在平衡工业化模型的迫切需求的同时,面临着大量的机会。 鉴于其数据、模型和技术,每个组织面临不同的挑战。 如果MLOps很容易,我们可能不喜欢解决问题。
挑战始终是优先级。
我们希望这本手册能够帮助您的团队产生新的思路和领域。第一步是为您的团队在2023年制定一份机会清单。 然后,根据对客户影响最大的基础,无情地对它们进行优先排序。 团队还可以根据新兴基准定义和测量其成熟度进展。 Google的这个指南可以为您的团队提供框架和成熟度里程碑。
您的团队的想法:
- 我们在MLOps方面提高成熟度或复杂度的最大机会是什么?
- 我们如何捕捉和跟踪推进成熟性的项目的进度?
- 为这个指南和您的团队生成一个任务列表。根据实施时间和预期效益进行优先排序。创建路线图。
参考文献
- https://www2.deloitte.com/content/dam/insights/articles/7022_TT-MLOps-industrialized-AI/DI_2021-TT-MLOps-industrialized-AI.pdf
- https://proceedings.neurips.cc/paper/2015/file/86df7dcfd896fcaf2674f757a2463eba-Paper.pdf
- https://developers.google.com/machine-learning/guides/rules-of-ml
- https://cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning
Mike Caravetta已使用分析提供了数亿美元的商业价值。 他目前领导着福特公司在制造和复杂性降低方面扩大MLOps。 Brendan Kelly,AlignAI的联合创始人,已帮助数十个组织在银行、金融服务、制造和保险行业加速MLOps。