实践教程
一步一步的指南:如何微调预训练的NLP模型以适用于任何领域
前言:本文提供了关于给定主题的信息摘要,不应被视为原创研究。本文中包含的信息和代码可能受到我过去从各种在线文章、研究论文、书籍和开源代码中阅读或见到的东西的影响。
合著者:Billy Hines
目录
- 介绍
- 理论框架
- 数据概览
- 起点:基线模型
- 模型微调
- 结果评估
- 总结思考
介绍
在当今世界中,预训练的NLP模型的可用性极大地简化了使用深度学习技术对文本数据进行解释。然而,尽管这些模型在一般任务上表现出色,但它们往往缺乏对特定领域的适应性。本全面指南旨在指导您如何通过微调预训练的NLP模型来在特定领域中实现更好的性能。
动机
尽管BERT和Universal Sentence Encoder(USE)等预训练的NLP模型在捕获语言细微差异方面非常有效,但由于它们训练时使用的数据集范围广泛,它们在特定领域的应用中的性能可能受到限制。当分析特定领域内的关系时,这一限制变得明显。
例如,在处理就业数据时,我们希望模型能够识别“数据科学家”和“机器学习工程师”之间的更紧密联系,或者“Python”和“TensorFlow”之间的更强关联。不幸的是,通用模型往往会忽视这些微妙的关系。
下表演示了基线多语言USE模型得到的相似度差异:

为了解决这个问题,我们可以使用高质量的领域特定数据对预训练模型进行微调。这个适应过程显著提升了模型的性能和准确性,充分发挥了NLP模型的潜力。
当处理大型预训练的NLP模型时,建议首先部署基线模型,只有当其在特定问题上的性能不足时才考虑微调。
本教程重点介绍如何使用易于获取的开源数据来微调Universal Sentence Encoder(USE)模型。
理论概述
微调机器学习模型可以通过各种策略实现,例如监督学习和强化学习。在本教程中,我们将集中讨论一种一(少)次学习方法,结合孪生网络架构进行微调。
方法论
在本教程中,我们使用孪生神经网络,这是一种特定类型的人工神经网络。这种网络利用共享权重同时处理两个不同的输入向量以计算可比较的输出向量。受到一次学习的启发,这种方法在捕获语义相似性方面被证明特别有效,尽管可能需要更长的训练时间并且缺乏概率输出。
孪生神经网络创建了一个“嵌入空间”,其中相关概念被紧密放置,使得模型能够更好地辨别语义关系。
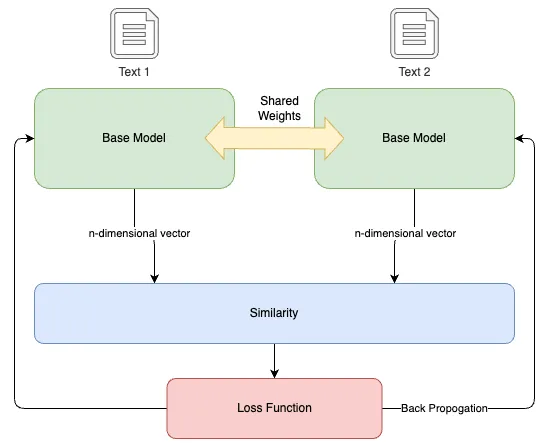
- 双分支和共享权重:该架构由两个相同的分支组成,每个分支都包含一个带有共享权重的嵌入层。这些双分支同时处理两个输入,可以是相似或不相似的。
- 相似性和转换:使用预训练的自然语言处理模型将输入转换为向量嵌入。然后,该架构计算向量之间的相似性。相似性得分在-1和1之间,量化了两个向量之间的角度距离,作为它们语义相似性的度量。
- 对比损失和学习:模型的学习通过“对比损失”来指导,该损失是预期输出(训练数据中的相似性得分)和计算得到的相似性之间的差异。该损失指导模型权重的调整,以最小化损失并提高学习嵌入的质量。
要了解更多关于单(少)样本学习、连体架构和对比损失的信息,请参考以下资源:
连体神经网络架构简介
连体神经网络架构:概述和关键概念解释及示例 | ProjectPro
www.projectpro.io
什么是一次性学习?— TechTalks
一次性学习允许深度学习算法测量两个图像之间的相似性和差异。
bdtechtalks.com
对比损失解释
对比损失最近在一些论文中得到了广泛应用,展示了在无监督情况下的最先进结果…
towardsdatascience.com
完整的代码可在GitHub上的Jupyter Notebook中获得
数据概述
对于使用此方法微调预训练的自然语言处理模型,训练数据应包含一对文本字符串及其之间的相似性得分。
训练数据的格式如下所示:
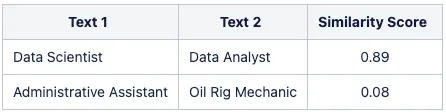
在本教程中,我们使用了从ESCO分类数据集中获取的数据集,该数据集已经进行了转换,以生成基于不同数据元素之间关系的相似性得分。
准备训练数据是微调过程中的关键步骤。假定您可以访问所需的数据并具有将其转换为指定格式的方法。由于本文的重点是演示微调过程,我们将忽略使用ESCO数据集生成数据的详细信息。
ESCO数据集可供开发人员免费使用,作为各种应用程序的基础,例如自动完成、建议系统、职位搜索算法和职位匹配算法。本教程中使用的数据集已经进行了转换,并提供为示例,可以无限制地用于任何目的。
让我们开始检查训练数据:
import pandas as pd# 从CSV文件中读取到pandas DataFrame中data = pd.read_csv("./data/training_data.csv")# 打印头部数据.head()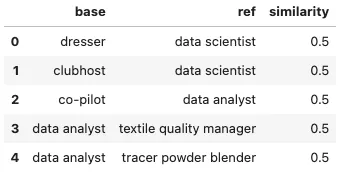
起点:基准模型
首先,我们将多语言通用句子编码器作为基准模型。在进行微调过程之前,设置这个基准是至关重要的。
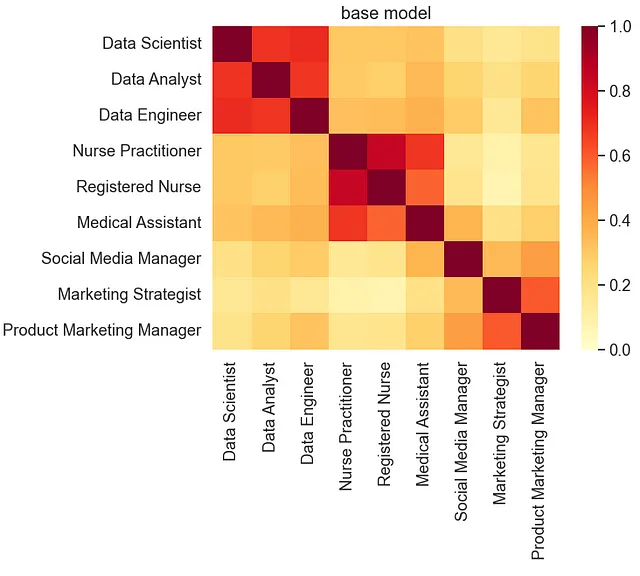
在本教程中,我们将使用STS基准和样本相似性可视化作为评估微调过程中的改变和改进的指标。
STS基准数据集由英语句子对组成,每个句子对都有一个相似性评分。在模型训练过程中,我们评估模型在这个基准集上的性能。每个训练运行的持久化分数是预测相似性评分与数据集中实际相似性评分之间的皮尔逊相关系数。
这些分数确保在模型使用我们的上下文特定训练数据进行微调时,它保持一定程度的泛化能力。
# 从TensorFlow Hub加载多语言通用句子编码器模块
base_model_url = "https://tfhub.dev/google/universal-sentence-encoder-multilingual/3"
base_model = tf.keras.Sequential([
    hub.KerasLayer(base_model_url,
                   input_shape=[],
                   dtype=tf.string,
                   trainable=False)
])

# 定义一个测试句子列表,这些句子表示各种工作职位
test_text = ['数据科学家', '数据分析员', '数据工程师',
             '护士执业医师', '注册护士', '医疗助理',
             '社交媒体经理', '营销策略师', '产品营销经理']

# 为测试句子列表中的句子创建嵌入向量
# 使用np.array()函数将结果转换为numpy数组
# 使用.tolist()函数将numpy数组转换为列表,这样更容易处理
vectors = np.array(base_model.predict(test_text)).tolist()

# 调用plot_similarity函数创建相似性可视化图
plot_similarity(test_text, vectors, 90, "基础模型")

# 计算基础模型的STS基准分数
pearsonr = sts_benchmark(base_model)
print("STS基准分数:" + str(pearsonr))
STS基准(开发集):0.8325
微调模型
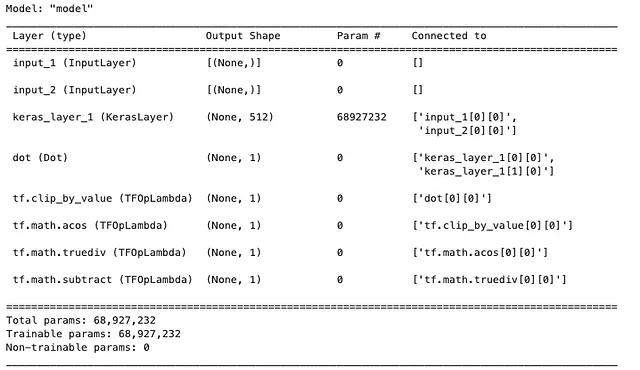
下一步是使用基线模型构建孪生模型架构,并使用我们的领域特定数据对其进行微调。
# 加载预训练的词嵌入模型
embedding_layer = hub.load(base_model_url)

# 从加载的嵌入模型创建一个Keras层
shared_embedding_layer = hub.KerasLayer(embedding_layer, trainable=True)

# 定义模型的输入
left_input = keras.Input(shape=(), dtype=tf.string)
right_input = keras.Input(shape=(), dtype=tf.string)

# 通过共享的嵌入层传递输入
embedding_left_output = shared_embedding_layer(left_input)
embedding_right_output = shared_embedding_layer(right_input)

# 计算嵌入向量之间的余弦相似度
cosine_similarity = tf.keras.layers.Dot(axes=-1, normalize=True)([embedding_left_output, embedding_right_output])

# 将余弦相似度转换为角度距离
pi = tf.constant(math.pi, dtype=tf.float32)
clip_cosine_similarities = tf.clip_by_value(cosine_similarity, -0.99999, 0.99999)
acos_distance = 1.0 - (tf.acos(clip_cosine_similarities) / pi)

# 打包模型
encoder = tf.keras.Model([left_input, right_input], acos_distance)

# 编译模型
encoder.compile(
    optimizer=tf.keras.optimizers.Adam(
        learning_rate=0.00001,
        beta_1=0.9,
        beta_2=0.9999,
        epsilon=0.0000001,
        amsgrad=False,
        clipnorm=1.0,
        name="Adam"
    ),
    loss=tf.keras.losses.MeanSquaredError(
        reduction=keras.losses.Reduction.AUTO, name="mean_squared_error"
    ),
    metrics=[
        tf.keras.metrics.MeanAbsoluteError(),
        tf.keras.metrics.MeanAbsolutePercentageError(),
    ],
)

# 打印模型摘要
encoder.summary()
训练模型
# 定义早停回调函数
early_stop = keras.callbacks.EarlyStopping(
    monitor="loss", patience=3, min_delta=0.001)

# 定义TensorBoard回调函数
logdir = os.path.join(".", "logs/fit/" + datetime.now().strftime("%Y%m%d-%H%M%S"))
tensorboard_callback = keras.callbacks.TensorBoard(log_dir=logdir)

# 处理模型输入
left_inputs, right_inputs, similarity = process_model_input(data)

# 训练编码器模型
history = encoder.fit(
    [left_inputs, right_inputs],
    similarity,
    batch_size=8,
    epochs=20,
    validation_split=0.2,
    callbacks=[early_stop, tensorboard_callback],
)

# 定义模型输入
inputs = keras.Input(shape=[], dtype=tf.string)

# 通过嵌入层传递输入
embedding = hub.KerasLayer(embedding_layer)(inputs)

# 创建微调模型
tuned_model = keras.Model(inputs=inputs, outputs=embedding)
评估
现在我们有了微调模型,让我们重新评估它并将结果与基本模型的结果进行比较。
# 为test_text列表中的句子创建嵌入。 # 使用np.array()函数将结果转换为numpy数组。# 使用.tolist()函数将numpy数组转换为列表,这样可能更容易处理。vectors = np.array(tuned_model.predict(test_text)).tolist()# 调用plot_similarity函数创建相似度图。plot_similarity(test_text, vectors, 90, "微调模型")# 为微调模型计算STS基准分数pearsonr = sts_benchmark(tuned_model)print("STS基准: " + str(pearsonr))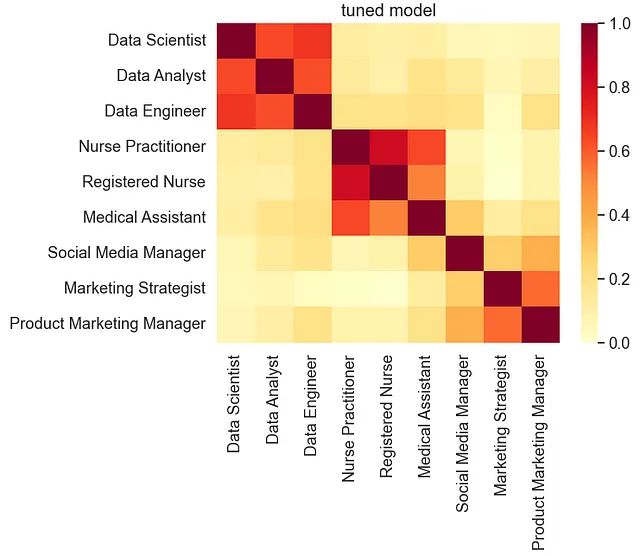
STS基准(开发集):0.8349
基于对相对较小的数据集进行微调,STS基准分数与基准模型相当,表明微调模型仍具有泛化能力。然而,相似度可视化展示了相似标题之间的相似度得分增强,以及不相似标题之间得分的降低。
结束语
对预训练的自然语言处理(NLP)模型进行领域适应的微调是一种提高其在特定环境中性能和准确性的强大技术。通过利用高质量、领域特定的数据集和利用连体神经网络,我们可以增强模型捕捉语义相似性的能力。
本教程提供了一个逐步指南,以使用通用句子编码器(USE)模型作为示例进行微调过程。我们探讨了理论框架、数据准备、基准模型评估和实际微调过程。结果证明了微调在领域内增强相似度得分的有效性。
通过遵循这种方法并将其适应到您的特定领域,您可以发掘预训练NLP模型的全部潜力,并在自然语言处理任务中取得更好的结果。
感谢阅读。如果您有任何反馈,请通过评论本文、LinkedIn上的消息或发送电子邮件(smhkapadia[at]gmail.com)与我联系。
如果您喜欢这篇文章,请访问我的其他文章。
评估主题模型:潜在狄利克雷分配(LDA)
逐步构建可解释主题模型的指南
towardsdatascience.com
自然语言处理的演变
语言模型发展的历史视角
小猪AI.com
Python中的推荐系统:LightFM
使用LightFM构建Python推荐系统的逐步指南
towardsdatascience.com